해킹을 진행하는 과정 중 정보 수집이라는 단계가 존재한다.
오늘은 다양한 정보 수집 기법에 대해 알아보자.
정보 수집이란
해킹에서의 정보 수집은 말 그대로 타겟에 대한 다양한 정보를 수집하는 것이다.
내가 아는 것, 내가 할 수 있는 것과 더불어서 타겟에 대한 정보를 많이 알 수록 발견하지 못했던 취약점을 발견해내고 시나리오를 짤 수 있게 된다. 그 외에도 정보 수집 과정 자체에서 취약점을 발견할 수도 있다.
수동 탐색
수동 탐색이란 정보 수집과정의 일부이자 가장 처음 진행하는 정보 수집 과정이다.
이는 해킹을 진행하기에 앞서, 타겟 서비스를 직접 이용해보는 과정이라고 할 수 있다.
단, 사용할 시 단순히 일반 사용자처럼 몇가지 기능만 사용해보는 것이 아니라 사이트의 처음부터 끝까지, 사소한 기능 하나하나 모두 테스트해 보는 것이 중요하다. 수동 탐색을 진행하며 공격자의 관점에서 시나리오를 정리할 수 있다.
구글 해킹(구글 도킹)
구글 해킹(또는 구글 도킹)은 구글 검색을 통해 타겟의 대한 정보를 수집하는 과정이다.
구글 검색 엔진은 검색할 때 특정 조건으로 필터링할 수 있는 연산자가 존재한다. 이제 몇가지 연산자의 종류를 소개하겠다.
| 연산자 | 기능 | 사용 예시 |
|---|---|---|
| site | 검색 결과 중 특정 사이트에서의 자료만 보고 싶을 때 | 노정원 site:njw.kro.kr |
| inurl | url 중에 특정 문자가 포함되어 있는 자료만 검색할 때 | inurl:admin |
| intitle | 페이지의 Title에 특정 글자가 포함된 페이지만 검색 | intitle : index of |
| link | 특정 Link를 포함하고 있는 페이지만 검색 | link:example.com |
| filetype | 특정 유형의 파일들만 검색할 때 | filetype:pdf 이력서 |
| wildcard | 모든 글자를 의미하는 글자 | 해킹 * 배우는 법 |
이러한 다양한 연산자를 효과적으로 사용한 예시는 아래와 같다.
site:.targetSystem.com - 특정 도메인의 사이트, 페이지들 검색
site:.targetSystem.com inurl:app/kibana - 타겟 도메인 중 특정 경로를 가지고 있는 페이지들을 찾아낼 때
site:s3.amazonaws.com TargetName - 특정 회사의 Amazon S3 버킷을 찾아낼 때
site:*.targetSystem.com ext:txt password - 타겟 도메인 사이트에서 text 파일 중 password 단어 검색
inurl:/etc/passwd root:x:0:0:root:/root:/bin/bash - LFI 취약점 사이트 검색 (site: 연산 추가)
intitle:index of - 디렉토리 리스팅 취약점 검색 (site: 연산 추가)
이러한 구글 해킹에 도움되는 예시들을 모아놓은 GHDB라는 서비스가 존재하니 참고 바란다.
Spidering(Crawling)
Spidering(Crawling)이란 서비스 내에 존재하는 하이퍼 링크와 같은 노출되는 다른 공격 표면을 수집하는 과정을 뜻한다.
수동 탐색과 다르게 봇이 직접 탐색하므로 미처 발견하지 못했던 공격 표면을 발견할 수도 있다.
이러한 웹 스파이더링을 진행하는 툴 중에 ZAP이라는 툴이 존재한다.
여기서 다운받을 수 있다.
S3 Bucket
S3(Simple Storage Service) Bucket이란 AWS 측에서 제공하는 클라우드 저장 서비스이다.
S3 Bucket을 단순히 관리 데이터를 저장하는 데이터베이스 서버로 쓰기도 하지만 여러가지 흥미로운 정보를 저장하는 백업 서버등으로 사용하는 경우도 있다. 이때 다른 숨겨진 서버나 로그, 크리덴셜과 같은 추가적인 정보를 발견할 가능성이 존재한다.
S3 버킷은 위에서 설명한 구글 도킹과 GrayhatWarfare, Bucket Stream이라는 툴로 찾을 수 있다.
S3 Bucket 구글 해킹
S3 Bucket은 구글 해킹을 통해 발견할 수 있는데
site:s3.amazonaws.com [Target]
또는
site:amazonaws.com [Target]
와 같은 방법을 사용할 수 있다.
S3 Bucket GrayhatWarfare
GrayhatWarfare는 인터넷에 무단으로 노출된 퍼블릭 클라우드 스토리지의 파일들을 수집하여 검색할 수 있도록 지원하는 오픈소스 기반 OSINT(개방형 정보 수집) 보안 검색엔진이다.
여기서 웹 서비스의 형태로 사용될 수 있으며 타겟 이름과 키워드등을 검색해 사용할 수 있다.
S3 Bucket Bucket Stream
Bucket Stream은 CT를 기반으로 S3 Bucket을 찾아준다.
CT(Certificate Transparency)는 CA가 잘못 발급한 인증서를 잡기 위한 공개 감시 체계이다. CA가 털려서 google.com 위조 인증서가 발급돼도 아무도 몰랐던 문제를 해결하려고 만듦.
내부 동작:
CA가 인증서 발급 → 공개 append-only 로그 서버에 제출 (Google Argon/Xenon, Cloudflare Nimbus, Let's Encrypt Oak 등)
로그 서버가 SCT(Signed Certificate Timestamp) 반환 → 인증서에 embed
브라우저는 SCT 없는 인증서를 거부 (Chrome은 2018년 4월부터 강제)
로그는 Merkle Hash Tree 구조라 과거 기록 삭제/변조 불가 → 누구나 감사 가능
Github Recon
github에서 발견할 수 있는 정보들을 수집하는 과정을 Github Recon이라고 지칭한다.
git은 버전 관리 플랫폼인데 이를 개인이 아닌 다수가 사용할 수 있도록 하는 서비스가 바로 github이다.
보안 관리 상 github은 매우 중요한데 github에 개발자가 남겨 놓은 크리덴셜 외에도 하드 코딩된 민감한 정보가 존재할 수 있기도 하고 발견하지 못했던 취약점을 발견할 수도 있기 때문이다. git 특성상 커밋을 제거하더라도 기록이 남기 때문에 매우 치명적이라고 볼 수 있다.
타겟 회사 이름, 프로젝트 이름, 개발자 이름(닉네임) 등을 검색하여 Github Repo를 찾아낼 수 있다. 찾아낸 뒤에는 Issues / Code Commits / Code History / Blame 현황을 조사하는 것이 중요하다. 이 부분에서 발생한 버그들과 버그를 패치한 과정을 볼 수 있기 때문이다.
코드 내에서 취약점을 찾아내는 키워드는 key, secret, password, cred와 같고 여기서 크리덴셜이 유효한지 확인할 수 있다.
Github Recon도 위와 마찬가지로 자동화 도구들이 존재한다.
바로 Gitrob과 TruffleHog이다.
이 도구들은 깃허브 토큰을 넣고 사용 가능하다.
Domain Enumeration
Domain Enumeration은 호스트 도메인을 이용해 하위 도메인을 찾는 과정이다.
이를 통해 공격 표면을 확장시킬 수 있고, 버그바운티를 진행할 시 공격 대상이 *.example.com일 때 진행한다.
Domain Enumeration은 인증서의 SAN(Subject Alternative Name)을 조사하거나 amass라는 도구를 사용하여 진행할 수 있다.
Domain Enumeration SAN
SAN은 한개의 인증서로 여러 도메인을 등록할 수 있는 기능인데, Domain Enumeration도 S3 Bucket과 마찬가지로 CT(Certificate Transparency)를 조사함으로써 진행할 수 있다.
추천하는 서비스는 여기다.
Domain Enumeration amass
amass는 정보 수집 도구인데, amass의 enum 속성을 통해 Domain Enumeration을 진행할 수 있다.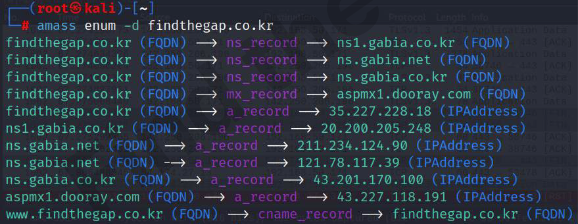
마무리
오늘은 해킹의 가장 첫 단계인 정보 수집에 대해 알아보았다!